Eco aveva previsto ChatGPT. Peccato che non l’avesse scritto
Una falsa “Bustina di Minerva” descrive con sorprendente precisione intelligenza artificiale, allucinazioni e contenuti sintetici. Ma la vera lezione non riguarda le capacità profetiche di Umberto Eco: riguarda la facilità con cui attribuiamo autorevolezza a un testo plausibile.
Per qualche ora è sembrata la profezia perfetta. In una presunta “Bustina di Minerva” del 2010, intitolata La macchina che avrà letto tutto, Umberto Eco avrebbe anticipato ChatGPT, le allucinazioni dei modelli linguistici, i compiti scolastici generati automaticamente e persino il rischio che le intelligenze artificiali imparino da contenuti prodotti da altre intelligenze artificiali.
Il testo è brillante, ironico, ricco di riferimenti eruditi e soprattutto terribilmente esatto. Una macchina capace di continuare frasi plausibili inventa un filosofo bizantino, gli attribuisce un trattato inesistente e indica persino la biblioteca in cui sarebbe conservato il manoscritto. Gli insegnanti cercano di riconoscere i temi artificiali; gli studenti chiedono alla macchina di aggiungere errori, banalità e un’opinione personale. Se poi Internet si riempirà di testi generati, una falsità ripetuta da cento siti potrà diventare verità per la macchina successiva.
Eco aveva davvero capito tutto? No. Eco non ha mai scritto quell’articolo.
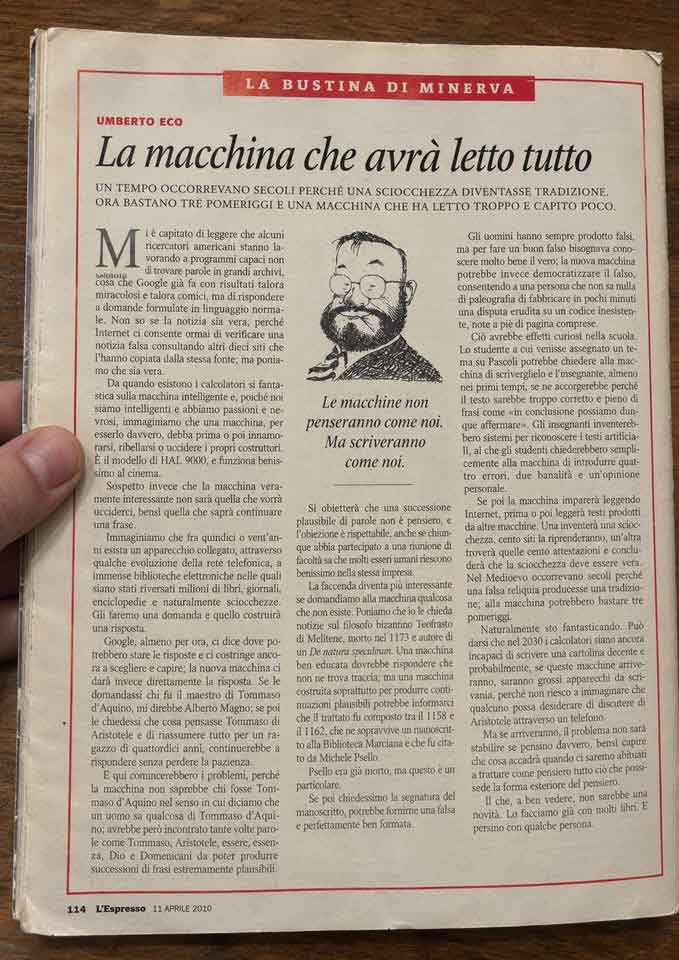
La fotografia della presunta pagina de L’Espresso è un falso, probabilmente generato o almeno composto digitalmente. Accanto al grande capolettera “M” compare una parola deformata e priva di significato, uno di quegli artefatti che i generatori di immagini lasciano quando devono riprodurre un’impaginazione tipografica. Il testo non compare negli archivi e, nello stesso periodo, L’Espresso attribuisce a Eco autentiche Bustine come Alto medio basso, pubblicata il 16 aprile 2010. Anche le verifiche di Tlon e BUTAC concordano: La macchina che avrà letto tutto è un apocrifo apparso nel 2026.
La scoperta non rende il testo meno interessante. Lo trasforma, semmai, in un esperimento quasi perfettamente echiano. Abbiamo creduto alla pagina non perché ne conoscessimo la provenienza, ma perché possedeva la forma giusta del pensiero di Eco: il Medioevo, le biblioteche, la cultura di massa, il gusto del paradosso e una battuta finale sugli esseri umani. L’autore del falso non doveva pensare come Eco. Doveva soltanto continuarlo in modo plausibile.
È precisamente ciò che fanno, a un livello fondamentale, i modelli linguistici. Durante l’addestramento imparano a prevedere il token successivo — una parola o una sua parte — sulla base delle regolarità presenti in enormi quantità di testi. L’architettura Transformer che ha reso possibile questo procedimento su larga scala risale al 2017. I sistemi che utilizziamo oggi aggiungono al modello di base istruzioni, ricerca sul Web, memoria, accesso a documenti e strumenti esterni, ma la generazione conserva una caratteristica essenziale: una frase può essere linguisticamente perfetta senza essere vera.
È così che nascono molte allucinazioni. Il sistema non consulta necessariamente un archivio nel quale ogni affermazione sia marcata come vera o falsa; produce la risposta che meglio corrisponde ai modelli appresi. Se mancano informazioni solide, può completare il vuoto con nomi, date e citazioni perfettamente verosimili. Una ricerca di OpenAI ha inoltre mostrato che molti criteri di valutazione premiano il tentativo di rispondere più dell’ammissione di incertezza. La macchina viene così incoraggiata a indovinare quando sarebbe preferibile che dicesse «non lo so».
Il falso semplifica invece il rapporto tra ripetizione e verità. Un modello non conclude automaticamente che una notizia sia corretta perché compare su cento siti: i dati possono essere selezionati, deduplicati e pesati, mentre una risposta può derivare dall’addestramento oppure da una ricerca eseguita in quel momento. Resta però reale il rischio di una rete popolata da copie sintetiche di altre copie. Uno studio pubblicato su Nature ha mostrato che l’addestramento indiscriminato su dati generati da modelli precedenti può causare il cosiddetto model collapse, con la progressiva perdita delle informazioni meno comuni e della varietà contenuta nei dati umani.
Eco aveva comunque previsto qualcosa di più profondo. Nel vero articolo del 2007 A che serve il professore? osservava che Internet avrebbe reso le nozioni immediatamente disponibili, senza eliminare il bisogno di qualcuno capace di insegnare a cercare, confrontare e selezionare. Il problema decisivo della rete, per Eco, non era l’accesso al sapere ma il filtraggio. Ed è esattamente il problema che l’intelligenza artificiale rende oggi più urgente: al disordine dei risultati di ricerca ha sostituito una risposta unica, ordinata e rassicurante.
Per chi segue il mondo Apple, la vicenda contiene un’ulteriore ironia. Il falso immagina queste macchine come grossi apparecchi da scrivania e considera improbabile che qualcuno voglia discutere di Aristotele attraverso un telefono. Un anno dopo la data attribuita all’articolo, Apple presentava iPhone 4S con Siri. Non era ancora intelligenza artificiale generativa, ma abituava milioni di persone a formulare domande in linguaggio naturale a un dispositivo tenuto in tasca.
Oggi Apple Intelligence distribuisce il lavoro tra modelli eseguiti sui chip di iPhone, iPad e Mac e modelli più grandi disponibili attraverso Private Cloud Compute. È un’architettura interessante perché affronta privacy, sicurezza e verificabilità dell’elaborazione. Ma non bisogna confondere questi aspetti con l’attendibilità del contenuto: una risposta può essere elaborata privatamente, senza lasciare il dispositivo, e restare completamente falsa. Un’allucinazione privata è pur sempre un’allucinazione.
La sfida per Apple e per l’intero settore non consiste quindi soltanto nel costruire modelli più potenti. Occorre progettare interfacce che distinguano ciò che il sistema sa, ciò che ha trovato in una fonte, ciò che ha dedotto e ciò che sta semplicemente generando. Citazioni, provenienza e ammissione dell’incertezza devono diventare funzioni dell’interfaccia, non avvertenze nascoste nelle condizioni d’uso.
Umberto Eco non aveva previsto ChatGPT in quella pagina, perché quella pagina non è sua. Aveva però studiato per tutta la vita il modo in cui i segni costruiscono credibilità e i falsi acquistano autorità.